Domain schoenheitschirurgie-konstanz.de kaufen?
Wir ziehen mit dem Projekt
schoenheitschirurgie-konstanz.de um.
Sind Sie am Kauf der Domain
schoenheitschirurgie-konstanz.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain schoenheitschirurgie-konstanz.de kaufen?
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
Was sind einige gängige Methoden zur Textklassifizierung und wie können sie zur Verbesserung der Genauigkeit von Maschinenlernalgorithmen beitragen?
Einige gängige Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netzwerke. Diese Methoden können die Genauigkeit von Maschinenlernalgorithmen verbessern, indem sie Muster in den Daten erkennen und die Klassifizierungsgenauigkeit erhöhen. Durch die Anwendung dieser Methoden können Maschinenlernalgorithmen besser trainiert werden, um präzisere Vorhersagen zu treffen. **

Ähnliche Suchbegriffe für Textklassifizierung
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
Drehstuhl Konstanz blauEinfacher Drehstuhl mit blauem Stoffbezug (95 % Polyester, 5 % andere). Das schwarz abgesetzte Gestell dieses Stuhls, sorgt für den nötigen Kontrast. Der Drehstuhl lässt sich zwischen 75-87 cm, durch Sicherheitsgasdruckfedern, höhenverstellen. Die Rollen sind für Teppichböden geeignet. Nur für den Heimbedarf geeignet.29,00 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **
-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **


Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
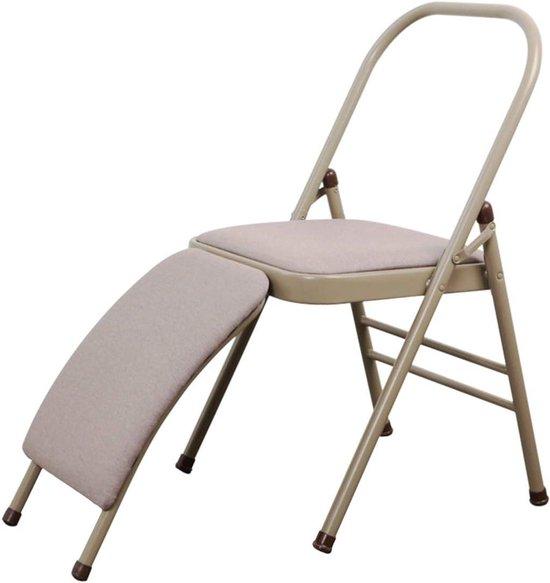
Yoga-Stuhl - Hilfsmittel zur Verbesserung des Gleichgewichts - Korrektur der Körperhaltung - Abnehmbare Lendenwirbelstütze - Zusammenklappbar - GrauVerbessern Sie Ihr Wohlbefinden mit diesem vielseitigen Yogastuhl, der speziell entwickelt wurde, um Ihren Rücken zu entlasten und Ihre Körperhaltung zu korrigieren. Er ist perfekt für alle, die zu Hause an ihrer Körperhaltung arbeiten und ihre Muskeln entspannen möchten. Dieser Stuhl ist Ihr idealer Partner für einen gesünderen Lebensstil. Verwenden Sie ihn für Gleichgewichtstraining, um Ihre Muskeln zu dehnen oder einfach nur, um bequem mit Unterstützung zu sitzen. Der Stuhl ist robust, mit einem verstärkten Stahlrohrdurchmesser von 25 mm und einem breiten, hautfreundlichen und atmungsaktiven Sitzkissen, das für zusätzlichen Komfort und Sicherheit sorgt. Ein besonderes Merkmal ist die abnehmbare Lendenwirbelstütze, die den Stuhl in einen normalen, aber stabilen Stuhl verwandelt. Dank des klappbaren Designs nimmt der Stuhl wenig Platz ein. Arbeiten Sie an Ihrer Flexibilität und Ihrem Wohlbefinden mit diesem praktischen und komfortablen Yogastuhl.589,07 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Drehstuhl Konstanz blauEinfacher Drehstuhl mit blauem Stoffbezug (95 % Polyester, 5 % andere). Das schwarz abgesetzte Gestell dieses Stuhls, sorgt für den nötigen Kontrast. Der Drehstuhl lässt sich zwischen 75-87 cm, durch Sicherheitsgasdruckfedern, höhenverstellen. Die Rollen sind für Teppichböden geeignet. Nur für den Heimbedarf geeignet.29,00 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
-
Was sind einige gängige Methoden zur Textklassifizierung und wie können sie zur Verbesserung der Genauigkeit von Maschinenlernalgorithmen beitragen?
Einige gängige Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netzwerke. Diese Methoden können die Genauigkeit von Maschinenlernalgorithmen verbessern, indem sie Muster in den Daten erkennen und die Klassifizierungsgenauigkeit erhöhen. Durch die Anwendung dieser Methoden können Maschinenlernalgorithmen besser trainiert werden, um präzisere Vorhersagen zu treffen. **
-
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **
-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
Ähnliche Suchbegriffe für Textklassifizierung
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
-
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.